
競馬予報について
各馬の走破タイムと道中の位置取りを確率分布として出力します。入力は各馬の過去走・コース適性・想定ペースに加えて、発走時刻の気温・湿度・風・降水量と、当日の馬場傾向です。
出す答えは1頭の「勝ち馬」ではなく、どのタイムがどれくらいの確からしさで出るかという区間です。予報と実測のずれは、外れた分も含めて検証ページで公開しています。
確率的アプローチ
競馬は多くの不確定要素(出遅れ、進路の壁、ペースの乱れ、当日の馬場状態など)が絡み合う複雑な競技です。そのため、単一の「勝ち馬」を1頭だけ予測することには限界があります。
本システムでは、各馬の基本能力、適性(距離・トラック・馬場)、ペース適応力、およびゲートからゴールまでの位置取りの変化を確率分布として推定します。これにより、誰が勝つかだけでなく、「どのような展開で、どれくらいの確率でその結果が起こるか」を分布として可視化します。
主な機能と見方
走破タイムの分布(箱ひげ図)
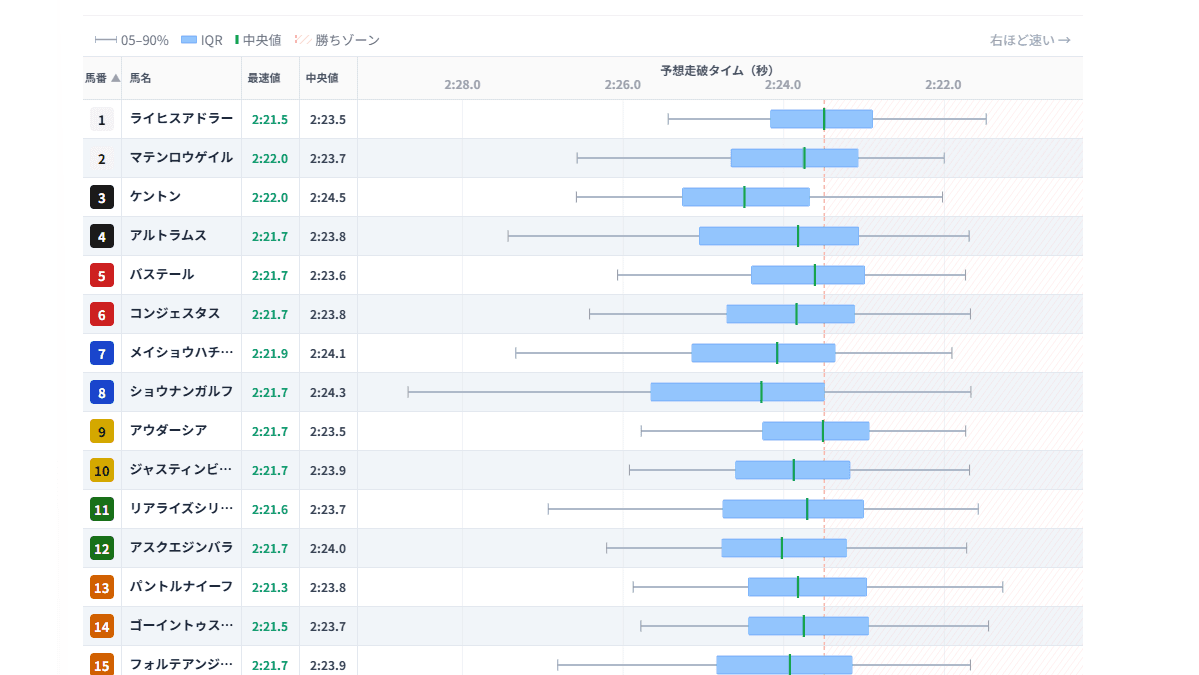
各馬がそのレースを走破する予測タイムの「バラつき」を箱ひげ図で表します。安定した走りが期待できる軸馬(分布の幅が狭い)や、ハマれば激走する可能性を秘めた穴馬(最速値が突出している)などを一目で見極めることができます。
位置取りシミュレーション
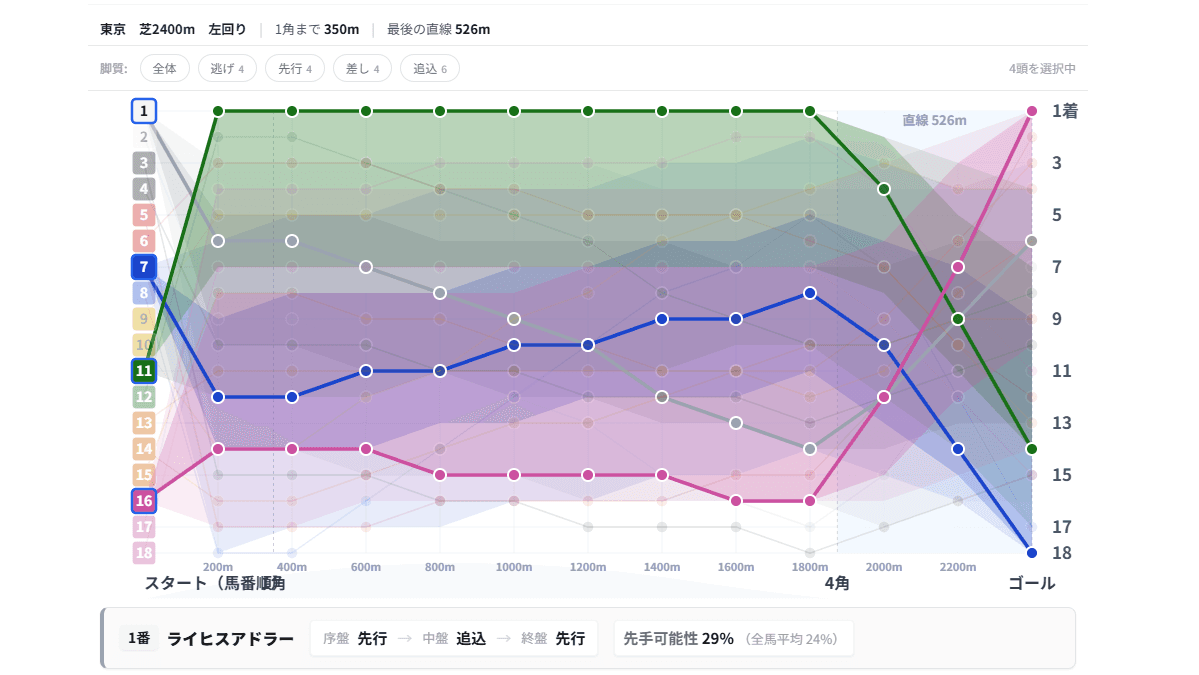
ゲートインから最後の直線までの位置取りの推移を予測します。逃げ・先行・差し・追込といった脚質を踏まえ、どの地点でどの馬がどのポジションにいるかを確率的に可視化し、レース全体の展開を読み解く補助をします。
能力レーダーチャート
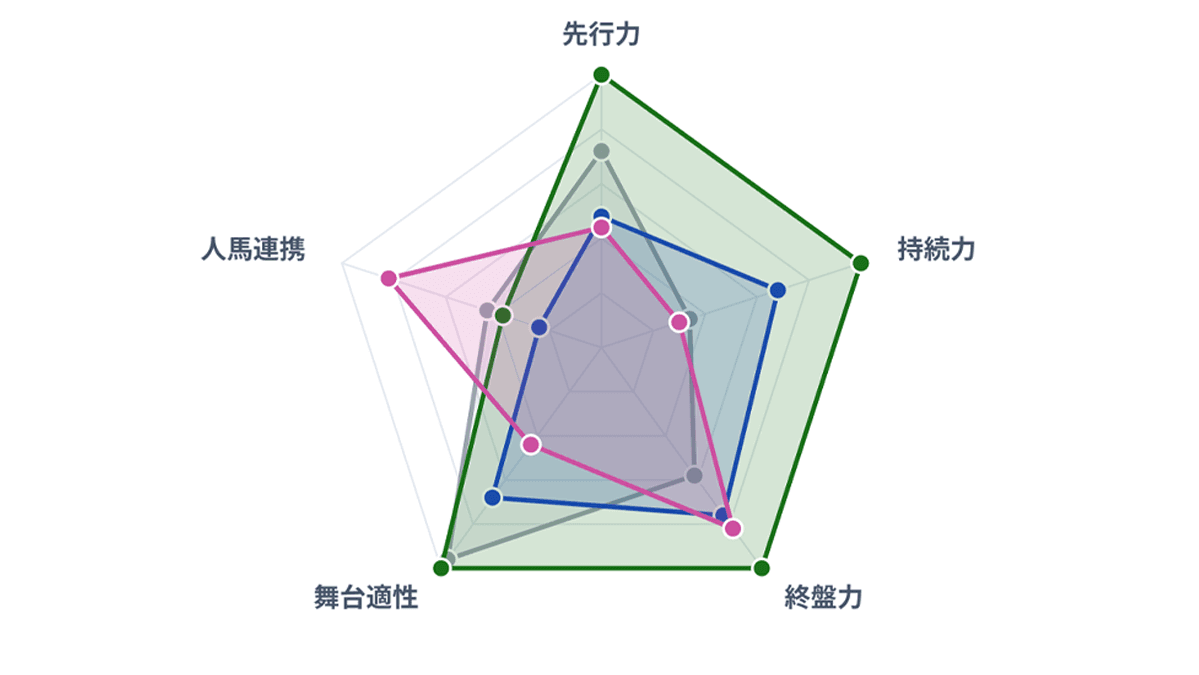
スピード、スタミナ、展開への対応力、直線の瞬発力など、各競走馬が持つ特徴や強みを多角的にスコア化しレーダーチャートで表示します。今回のコース特性にどの馬が最もフィットしているかが直感的に理解できます。
過去実績(走破タイム / 上がり3F)
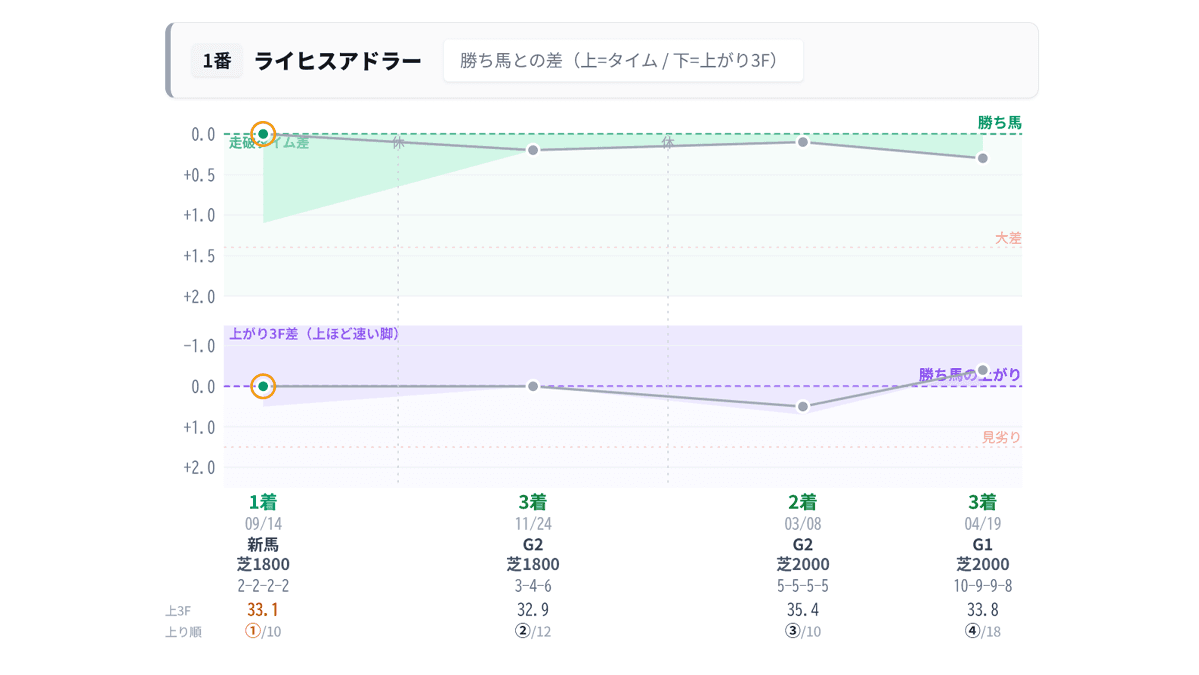
各馬の過去走を「勝ち馬との差」に揃えて並べます。上段が走破タイム差、下段が上がり3F差。モデルの推定ではなく実測値そのもので、同一条件(場・路面・距離・内外)での実績にはリングを付けて区別しています。
予報サマリーと統計的特異点
シミュレーション空間の出力から、予測走破タイムの分布が他馬から隔たっている馬や、タイムの振れ幅が極端な馬を「統計的特異点」として自動抽出します。本サイトは買い目・期待値・回収率および勝率を一切提示しません。可視化されたデータに基づく判断は、訪問者ご自身に委ねられます。
予報ができるまで
競馬予報は、天気予報とよく似た三段構えで作られています。①観測データを特徴量に変換する、②統計モデルで走破タイムを予測する、③そのレースを何度も走らせて結果の分布を得る。 以下、それぞれを順に説明します。
特徴量 — レースを約320個の数値に翻訳する
モデルは「馬名」や「新聞の印」を見ません。過去の全レース記録・血統・馬体重・騎手/厩舎の成績・コース形状・そして当日の気象を、1頭 × 1レースあたり約320個の数値に変換したものだけを入力とします。特徴量は次の13ファミリーに整理されています。
- コンテキスト距離・馬場・クラス・頭数など前提条件
- 正規化タイムコース差を除いた実力の共通尺度
- 潜在能力過去走から推定した素の走力
- ペース形状レースの流れと脚質の噛み合い
- ローリング成績直近成績の移動集計
- 関係者騎手・厩舎・馬主のベイズ縮小成績
- ラップ適性区間ラップへの適応度
- 馬体体重・増減・成長曲線
- 血統父・母父系統の適性事前分布
- 市場オッズ・人気に含まれる集合知
- ガバナンスデータ欠損や信頼度のフラグ
- 気象気温・風・降水と馬場の含水状態
- 交互作用上記どうしの掛け合わせ
特徴量はすべて「そのレースの発走時点で知り得た情報」だけで作られます。 レース後にしか分からない値(着順や上がり3Fなど)が紛れ込むと精度は簡単に跳ね上がりますが、それは未来を覗いているだけで、本番では役に立ちません。
詳しく:馬場の含水量を「バケツ」でシミュレートする
気象特徴量の中核は、各競馬場・各路面の保水量を1時間刻みで追跡する水収支バケツモデルです。 降水量から遮断損失を引き、気温・湿度から求めた飽差と風速で蒸発量を計算し、容量上限つきのバケツの水位を更新します。出力は0(乾燥)〜1(飽和)の飽和度で、良/稍重/重/不良という4段階の公式馬場発表を連続量に分解したものに相当します。
公式馬場ラベル約78万行に対する順位相関は、芝 ρ=0.655 / ダート ρ=0.741。 従来使っていた単純な24時間降水量(芝0.590 / ダート0.540)を上回り、特にダートで差が大きく出ました。 モデル全体に占める気象系の寄与度(gain)も 5.31% → 6.66% に上昇しています。
また、気象は各レースの実際の発走時刻に合わせて割り当てます。固定の時間割で代用していた頃は、 順延や夏の夕方開催で最大2.7℃の系統誤差が出ていました。
モデル — 1点ではなく「幅」を予測する
中核となるモデルは、各馬の走破タイム(秒)を予測します。勝つ/負けるの分類ではなく、 物理的に意味のある量を直接推定するのがこのシステムの立場です。
そして予測するのは1つの値ではありません。下位10%・中央値・上位90%の3本の分位点を別々に学習し、 「速ければこのくらい、平凡ならこのくらい、崩れればこのくらい」という帯を出します。 同じ中央値でも、帯の狭い馬は計算の立つ馬、広い馬は上振れも下振れもある馬です。
この帯は放っておくと自信過剰になります。実測と突き合わせた結果、 「80%の確率でこの範囲」と表示していた区間に実際は21%しか収まっていなかった時期があり、現在は実測に合わせて幅を較正し直しています。
詳しく:アルゴリズムと学習期間
- アルゴリズム:LightGBM による分位点回帰(pinball loss)。q10 / q50 / q90 の3モデルを独立に学習。
- 学習期間:2025年1月1日より前のレースのみ。較正(コンフォーマル予測による区間補正・勝率のアイソトニック回帰)は2025年、評価は2026年と、期間を厳密に分離しています。
- 時点保護:推論時に過去成績を集計する処理にも「予報日より前」のガードを入れ、過去日を再現しても未来の情報が混ざらないようにしています。
- コース補正:同一開催日の全レースから馬場の速さの偏り(トラックバリアント)を推定し、タイムのアンカーを日ごとに較正します。
順位の確率 — 走らせずに、積分して出す
モデルが出した各馬のタイム分布から、「その馬が1着になる確率」「3着以内に入る確率」を計算します。 以前は仮想レースを1,000回走らせて頻度を数えていましたが、現在は数式を直接解いて厳密に求めています。 「他の全馬より速い確率」は各馬のタイム分布から積分で書ける量なので、乱数を使う必要がありません。 サンプリング由来の誤差はゼロで、同じ入力からは必ず同じ答えが出ます。
レース全体の性格として、3つのシナリオの起こりやすさを見積もっています —先行崩壊(前が競り合って総崩れ)、中立、前残り(そのまま押し切り)。 この3つの出現確率は、各馬が内外どのレーンを回るかの確率に重みとして反映され、位置取り予報の形を変えます。
一方で、シナリオによる走破タイムへの加減算は、現在ゼロに設定しています。 「前が崩れたら差し馬を何秒速くするか」という補正の大きさを実測で検証したところ、 当てずっぽうに順位を入れ替えているだけで予測精度をはっきり悪化させることが分かったためです。 補正の大きさをデータからゼロベースで較正し直すまで、この項は切ってあります。
最終的に、各馬の着順の確率分布と、走破タイムの分位(箱ひげ図の各点)が出ます。どちらも近似ではなく、モデルが出した分布から直接計算した値です。本サイトは買い目・期待値・回収率および勝率を一切提示しません。
※ 2026年9月より順序統計の厳密解(Gauss–Legendre 求積)へ移行しました。それ以前に公開・蓄積された過去の予報データは、モンテカルロシミュレーション(1,000試行)により算出されています。
使用している手法
独自の秘密の理論は使っていません。いずれも統計・機械学習の分野で確立された標準的な手法で、 名前を出しておけば「何をやっているか」は専門家であれば追試できるはずです。
- 走破タイムの予測
- LightGBM(勾配ブースティング決定木)による分位点回帰 / pinball loss
- 予測区間の較正
- モンドリアン・コンフォーマル予測(Mondrian Conformal Prediction)
- 勝率の較正
- アイソトニック回帰(Isotonic Regression)
- 着順分布の生成
- 順序統計の数値積分(split-normal・複合ガウス・ルジャンドル求積)
- 騎手・厩舎・血統の成績
- 経験ベイズ縮小推定(少数走の過大評価を抑える)
- 馬場の速さ補正
- トラックバリアント(開催日ごとの指数加重移動平均)
- 馬場の含水状態
- 水収支バケツモデル(Magnus 式による飽差からの蒸発推定)
- データ処理基盤
- Python / Polars / scikit-learn / NumPy
- データソース
- netkeiba(競走成績・オッズ)/気象庁アメダス(時別気象観測)
どこまで当たり、どこから当たらないか
2025年1月〜2026年7月の5,256レース・全10場を対象に、 モデル・特徴量・較正のすべてを検証期間より前の情報だけで作り直した別系統で推論し、実測と突き合わせました。 当たった部分と外れた部分を同じ強さで公開します。
※ ここの数字は上記 5,256 レースを母集団としたモデル評価用の別系統による値です。 予報精度 のページに出している ρ は、実際に本サイトへ掲載した予報を母集団とした別集計で、対象レース・期間・生成系統が異なるため数値も一致しません。 どちらも当たったレースだけを抜く操作はしていません。
- 走破タイムの絶対値
- 同条件の過去平均より正確。ここが最も硬い
- 着順の序列
- 順位相関 ρ = +0.52。半分は当たる
- 道中の位置取り
- 推移は読めるが、着順予測への上乗せはほぼゼロ
- 直線に入ってから
- ρ = +0.07。シグナルはほぼ消える
- 会場差
- 全10場で +0.47〜+0.54 に収まり、特定場に偏らない
- 「どの馬が勝つか」
- Top-1 的中 27% 対 1番人気 33%。市場には勝てていない
つまりこのシステムが提供できるのは「レースがどういう時計とどういう流れになるか」の解像度であって、 勝ち馬の名指しではありません。個々のレースの答え合わせは、各レースの検証ページで公開しています。
よくある質問 (FAQ)
Q.シミュレーションデータはいつ更新されますか?
出走馬と枠順が確定した後にデータ処理とシミュレーションを実行し、原則としてレース前日に公開します。 反映されるのは前走までの競走成績・馬体重・オッズ・当日の想定気象と馬場傾向で、 いずれも上の「特徴量」に挙げた 13 ファミリーの範囲です(調教タイムや調教評価は入力に含みません)。
Q.シミュレーションは何回行っていますか?
回数という考え方を使っていません。以前はレースごとに 1,000 回のモンテカルロシミュレーションを回していましたが、現在は順位確率を数式で厳密に解いています。試行回数に由来する推定誤差がゼロになるためで、乱数を使っていた頃は、順位確率に平均 ±0.6ポイント程度のぶれがあり、上位候補の並びが試行の引き直しで入れ替わることが約10レースに1回ありました。現在はそれが起きません。同じ入力からは、いつ・どのレースと一緒に計算しても、必ず同じ予報が出ます。
Q.すべてのレースが対象ですか?
JRA の平地競走であれば、開催日・競馬場・クラスを問わず全レースが対象です(1開催日あたりおおむね 33〜36 レース)。障害競走は対象外で、 データ整備の段階で除外しています。飛越の巧拙という平地とは別の要因が支配的で、 走破タイムを共通の尺度に載せられないためです。地方競馬(NAR)も現時点では対象に含みません。
ご利用にあたっての免責事項
本システムが提供する予測データ、能力レーダー、位置取り展開は、過去の競走馬成績データ等をもとに数学的・統計的モデルに基づいてシミュレーションしたものであり、実際のレース結果を保証するものではありません。
馬券の購入は、お客様ご自身の自己責任において行っていただきますようお願い申し上げます。万が一、本システムの利用によって損失が生じた場合でも、当サイトおよび開発者は一切の責任を負いかねます。